Como reduzir o tempo de resposta no WhatsApp com inteligência artificial é, hoje, uma das decisões de negócio com retorno mais rápido para equipes de atendimento. E os números explicam por quê: cerca de 57% dos clientes brasileiros desistem de um atendimento quando não recebem resposta no WhatsApp em até cinco minutos. Esse dado, aliás, está alinhado a levantamentos sobre comportamento do consumidor digital no Brasil. Afinal, esse percentual não representa frustração isolada; representa receita que some antes mesmo de o atendente abrir a conversa. Além disso, benchmarks setoriais de 2026 mostram que serviços profissionais respondem em média em 6 min 15 s e o e-commerce em 2 min 45 s. Em muitos casos, são tempos que já ultrapassam o limiar de tolerância para atendimentos que demandam agilidade. Por outro lado, operações que adotaram automação com inteligência artificial chegam a menos de trinta segundos na primeira resposta para consultas simples. É o que mostram relatos de plataformas com dados operacionais publicados.
Na prática, plataformas maduras de automação eliminaram filas de espera em operações de médio porte sem necessidade de contratações adicionais. O volume escala; o custo de folha, não. Em resumo, esse é o resultado prático de automatizar o ponto certo do atendimento, e é exatamente o que este guia mostra como replicar.
Assim, ao terminar a leitura, você terá um plano de quatro etapas, modelos de mensagem prontos para adaptar e os indicadores certos para aferir, na prática, a queda no tempo de resposta da sua operação.
O custo de responder tarde no WhatsApp vai além da demora
Quando um lead manda mensagem no WhatsApp, ele está no pico da intenção de compra. Por isso, cada minuto que passa esfria essa intenção. Por exemplo, os benchmarks setoriais citados acima mostram que, no caso dos serviços profissionais (6 min 15 s), o tempo está acima do limiar de cinco minutos que pesquisas de comportamento do consumidor apontam como tolerância média. Já o e-commerce (2 min 45 s) fica abaixo desse limiar, o que indica que o problema é mais agudo em segmentos com resposta mais lenta.
Além disso, leads que recebem resposta em menos de um minuto convertem em taxas significativamente maiores do que os que esperam mais de cinco minutos. O MIT Lead Response Management Study aponta que responder na primeira janela pode gerar até 21 vezes mais chance de qualificação do que responder após trinta minutos. Em outras palavras, o comportamento é direto: o cliente abre, aguarda pouco e, se não há retorno, vai ao concorrente.
A matemática do gargalo humano
Em síntese, o problema tem raiz estrutural. Na prática, um atendente consegue gerenciar com qualidade entre três e cinco conversas simultâneas, heurística amplamente adotada em operações de suporte digital. Consequentemente, quando o volume sobe, o tempo de resposta sobe junto. Além disso, fins de semana, horário noturno e feriados criam buracos de cobertura que nenhuma grade de turnos resolve sem elevar o custo de folha. Portanto, o problema não é falta de esforço da equipe; é uma limitação de arquitetura.
Como reduzir o tempo de resposta no WhatsApp com inteligência artificial: automação da primeira interação
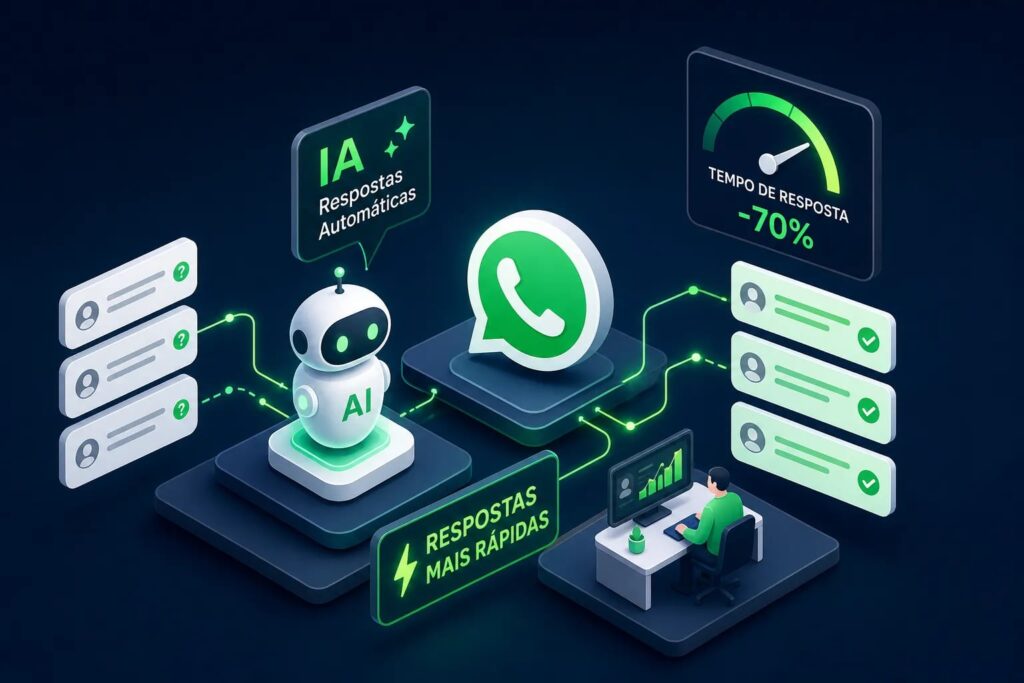
Nesse sentido, a automação da primeira resposta é o passo com maior retorno imediato. Enquanto o atendente humano ainda não abriu a conversa, o agente de inteligência artificial já cumprimentou o contato, coletou o nome, identificou a intenção e iniciou o fluxo correto. Consultas simples que antes levavam quatro minutos em média passam a ser resolvidas em menos de trinta segundos com automação básica de entrada. Esse ganho, no entanto, se aplica a intenções de baixa complexidade e fluxos bem mapeados.
Essa primeira interação reduz o tempo percebido de espera mesmo quando um humano ainda precisa entrar depois. Afinal, o cliente sente que foi atendido, o que muda completamente a experiência antes mesmo de qualquer resolução real. Como resultado, essa diferença de percepção tem impacto direto na satisfação final.
O agente de inteligência artificial funciona como um colaborador virtual disponível 24 horas por dia, sete dias por semana, sem ampliar o quadro de pessoal. Por exemplo, a App2work entrega agentes de IA configurados para responder simultaneamente a centenas de contatos, sem pausas e sem limite de janela de atendimento. Para pequenas e médias empresas, isso significa escalar o volume de atendimento sem escalar o custo de folha. Com base em operações monitoradas pela plataforma, equipes menores conseguem cobrir volumes antes inviáveis sem IA. No entanto, os ganhos exatos variam conforme o tipo de operação e os fluxos configurados.
Triagem e encaminhamento: o que a inteligência artificial decide antes do humano entrar
A IA interpreta antes de responder. Por meio de processamento de linguagem natural, o agente identifica a intenção por trás da mensagem e roteia o contato para o fluxo certo. “Quero saber o preço” vai para o fluxo comercial. “Meu pedido não chegou” vai para suporte. “Preciso falar com alguém” vai direto para um atendente humano. Isso elimina o tempo que o cliente normalmente gasta sendo redirecionado de forma manual. Por isso, é um dos principais mecanismos de redução do tempo médio de resposta no WhatsApp com inteligência artificial.
Além disso, plataformas maduras oferecem roteamento automático por intenção. Por sua vez, a App2work constrói esses fluxos sob medida para cada operação, o que garante que o roteamento reflita a realidade do negócio, e não um modelo genérico. Afinal, um fluxo calibrado para o seu perfil de cliente tende a converter mais do que um fluxo padrão de mercado.
Handoff sem atrito: como preservar a experiência na transferência
O handoff mal feito destrói a experiência: o cliente precisa repetir tudo para o atendente humano. Por isso, a inteligência artificial deve passar o histórico completo da conversa no momento da transferência, junto com um resumo do assunto, do pedido e do motivo da escalada. Os gatilhos mais eficazes para o handoff incluem: pedido explícito por humano, baixa confiança do agente, repetição de falha, temas sensíveis como reclamação ou reembolso, e negociações de alto valor. Dessa forma, definir esses gatilhos com precisão reduz transferências desnecessárias e mantém o nível de serviço mesmo quando o humano assume.
Templates que automatizam sem soar como robô
O tom humano em mensagens automáticas depende sobretudo de personalizar a abertura e evitar linguagem corporativa. Na prática, uma pergunta real substitui qualquer menu genérico e aumenta o engajamento de forma consistente. Um modelo de chatbot para WhatsApp bem escrito soa como conversa, não como formulário.
Veja um modelo de primeiro contato com estrutura comentada, e note como cada elemento cumpre uma função:
“Olá, {nome}! Aqui é a equipe da {empresa}. Recebi sua mensagem e quero te ajudar da melhor forma. Pode me contar rapidamente o que você precisa?”
Em resumo, esse modelo usa o nome do cliente, voz em primeira pessoa, pergunta aberta e nenhum menu forçado. Em seguida, a automação apresenta opções apenas se o cliente não responder com uma intenção clara. Para qualificação, adicione uma segunda mensagem com duas ou três alternativas objetivas e mantenha sempre visível a possibilidade de falar com um atendente.
Fluxo de pós-atendimento e reativação
Para pós-atendimento, um fluxo de mensagens bem posicionadas mantém o cliente engajado sem intervenção humana: confirmação do pedido, atualização de status e uma pergunta de NPS simplificada. Além disso, esse mesmo fluxo serve como resposta automática no WhatsApp para recuperação de leads inativos. Uma mensagem direta, breve e sem pressão tende a reativar entre 10% e 20% dos contatos que não responderam na primeira abordagem. Essa faixa, de fato, é observada em operações com fluxos de reengajamento estruturados.
KPIs para reduzir o tempo de resposta no WhatsApp com inteligência artificial
No entanto, monitorar volume de mensagens é diferente de aferir qualidade de atendimento. Por isso, os indicadores que realmente mostram se a automação está funcionando são: tempo médio de primeira resposta (TMPR), taxa de resolução automática, taxa de transferência para humano e índice de satisfação pós-atendimento (CSAT).
Na prática, com automação básica, o TMPR deve cair para menos de cinco minutos. Com inteligência artificial e roteamento por intenção configurados corretamente, o alvo é menos de um minuto para intenções simples. Essa referência, aliás, é compatível com benchmarks de plataformas de automação conversacional. Já a taxa de resolução automática indica quantas conversas o agente fecha sem precisar de humano; operações maduras costumam resolver entre 50% e 70% do volume total sem intervenção. A taxa de transferência, por sua vez, sinaliza onde os fluxos precisam de ajuste: se estiver acima de 40%, os gatilhos estão mal calibrados.
Para estimar o retorno sobre o investimento, use a fórmula: (Ganho total menos Custo total) dividido pelo Custo total, multiplicado por 100. Exemplo com dados hipotéticos: 10.000 mensagens por mês, 60% resolvidas pelo agente, tempo médio humano de cinco minutos por atendimento e custo do atendente em R$ 25 por hora resultam em economia mensal de mão de obra de R$ 12.500. Assim, com uma plataforma custando R$ 5.000 por mês, o ganho líquido é de R$ 7.500 e o ROI fica em 150%. Ao incluir leads captados fora do horário comercial, esse número pode subir substancialmente. Por isso, refaça o cálculo com seus próprios dados antes de qualquer decisão de implantação.
Plano de 4 etapas para implantar inteligência artificial no WhatsApp
Em primeiro lugar, a sequência importa. Afinal, começar pela ferramenta antes de entender o fluxo atual é o erro mais caro que uma empresa pode cometer nessa implantação. O plano correto segue esta ordem:
- Mapeie os principais tipos de mensagem que sua operação recebe hoje. Esses são os fluxos que a inteligência artificial vai cobrir primeiro. De fato, sem esse mapeamento, qualquer automação vai criar lacunas no atendimento. O exercício costuma levar menos de uma hora em operações com histórico de conversas. No entanto, o tempo real varia conforme a complexidade e a disponibilidade dos dados.
- Escolha a plataforma pelos critérios certos: processamento de linguagem natural para identificação de intenção, integração com a API oficial do WhatsApp Business e transferência para humano com histórico completo da conversa. Esses critérios eliminam a maioria das soluções genéricas do mercado e garantem que o sistema de resposta automática no WhatsApp funcione de ponta a ponta.
- Construa e teste o fluxo de boas-vindas e triagem antes de qualquer outra coisa. Esse é o fluxo que vai impactar todos os contatos desde o primeiro dia. Portanto, garanta que ele funciona antes de expandir.
- Monitore o TMPR na primeira semana e ajuste os gatilhos de roteamento. Os primeiros sete dias em produção revelam padrões que o teste interno não captura. Itere rápido.
A App2work oferece demonstração do fluxo real para que você avalie o funcionamento do agente com o seu tipo de operação antes de qualquer decisão.
Erros frequentes e como corrigi-los
De modo geral, os erros mais comuns nessa implantação têm correção direta. O primeiro é tentar automatizar tudo de uma vez: comece pelos fluxos mapeados na etapa um e expanda depois. O segundo é não configurar a transferência adequada, o que faz o cliente repetir informações para o atendente humano. Por isso, passe sempre o histórico completo. Por fim, o terceiro é usar linguagem genérica nos modelos, o que reduz engajamento e aumenta abandono: use o nome do cliente, faça perguntas reais e elimine o vocabulário corporativo.
O próximo passo é mais simples do que parece
Saber como reduzir o tempo de resposta no WhatsApp com inteligência artificial não exige um projeto de TI de seis meses. Em muitas operações, é possível ver retorno sobre o investimento já no primeiro mês, desde que o escopo seja claro e as integrações necessárias estejam disponíveis. Dessa forma, você agora tem os dados de referência por setor, os modelos comentados, os indicadores corretos e um plano de quatro etapas em ordem lógica.
Comece pelo mapeamento dos principais tipos de mensagem que sua operação recebe hoje. Com esse mapa em mãos, o fluxo de triagem se constrói em dias, não em meses. Essa estimativa, porém, vale para operações com fluxos bem definidos e sem integrações complexas.
Para quem quer pular a fase de configuração inicial e entrar direto em produção, a App2work oferece agentes pré-configurados para diferentes tipos de operação. Portanto, agende uma demonstração gratuita e veja o resultado antes de qualquer decisão.